AI动漫视频
1. 介绍
AI动漫视频可以把一段剧本(或产品卖点)做成多镜头的短视频:AI 先把剧本拆成角色和分镜,再逐个镜头生成剧照和视频片段,最后连续预览、合成成片、打包下载。适合动漫短片、宣传广告、短视频带货等场景。
制作流程:
填写剧本 → AI拆分剧本 → 检查、修改分镜 → 生成剧照(可选) → 生成视频 → 预览、合成成片、打包下载
视频由第三方视频模型生成,按秒计费。每次提交前系统都会弹窗显示预估费用,确认后才会提交。
2. 准备工作:配置模型
制作一个作品会用到三类模型,都在「AI应用 → AI模型配置」中添加:
| 用途 | 模型类型 | 说明 |
|---|---|---|
| 拆分剧本 | 语言模型 | 任意已配置的语言模型,如 DeepSeek、通义千问 |
| 生成剧照 | 图像模型 | 任意已配置的文生图模型,推荐通义万相(默认不带水印);不出剧照可以不配 |
| 生成视频 | 视频模型 | 火山方舟(豆包 Seedance)、MiniMax(海螺 H3)、智谱(CogVideoX、Vidu),添加方法见下文 |
语言模型和图像模型的添加方法见 AI模型配置,下面介绍视频模型。
2.1 添加视频模型
进入「AI应用 → AI模型配置」,点击「添加模型」,在右上角选择「视频模型」,可以看到支持视频生成的供应商:
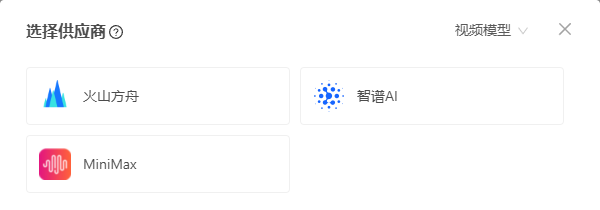
以火山方舟为例,选择「火山方舟」后填写:
- 模型名称:自定义,如
豆包Seedance视频 - 模型类型:视频模型
- 基础模型:从下拉中选择,如
doubao-seedance-2-5-260628 - API域名:选择供应商后自动带出,一般不用改
- API Key:在火山方舟控制台创建的 API Key
- 视频参数:可以不填,使用默认值(见 2.2 视频参数)
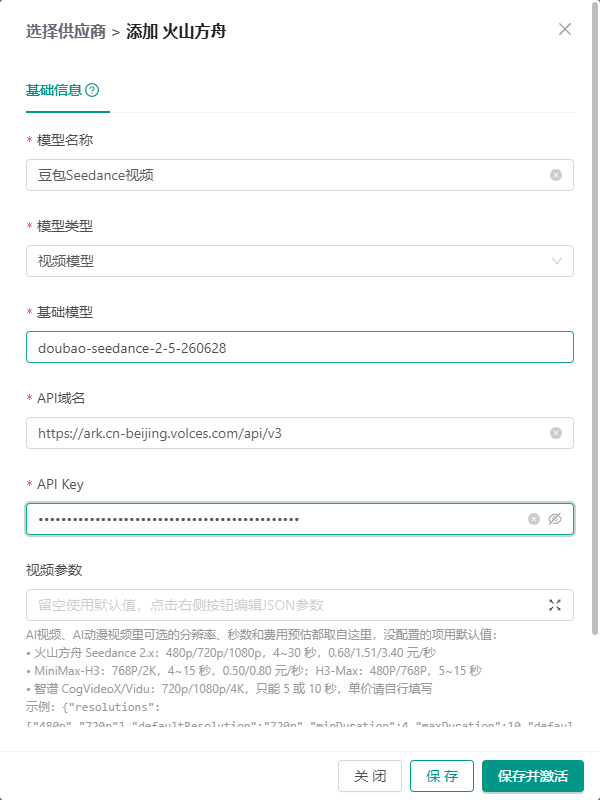
点击「保存并激活」。激活时只调用供应商的任务查询接口来校验 API Key,不会生成视频,也不会产生费用。激活成功后,在模型列表中可以看到这个视频模型:
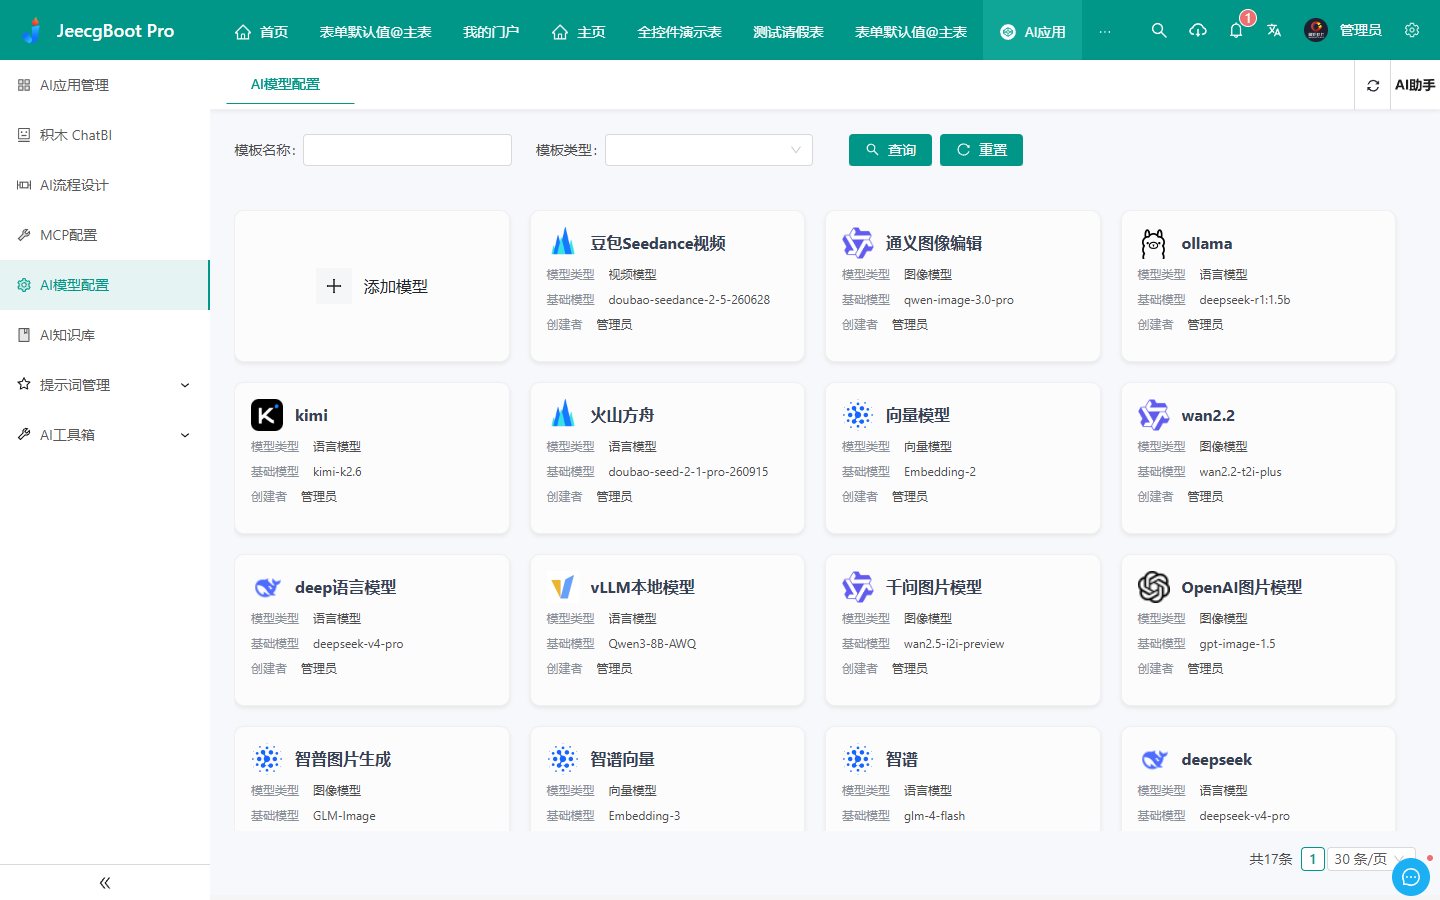
只有已激活的视频模型才会出现在 AI动漫视频、AI视频的模型下拉中。
三家供应商的填写参考:
| 供应商 | 基础模型 | API域名(自动带出) |
|---|---|---|
| 火山方舟 | doubao-seedance-2-5-260628(Seedance 2.5)doubao-seedance-2-0-260128(Seedance 2.0)doubao-seedance-2-0-fast-260128(Seedance 2.0 快速版) | https://ark.cn-beijing.volces.com/api/v3 |
| MiniMax | MiniMax-H3MiniMax-H3-Max(极速版) | https://api.minimax.cn |
| 智谱AI | cogvideox-3、cogvideox-2viduq1-text | https://open.bigmodel.cn/api/paas/v4 |
API Key 需要到各供应商平台自行申请,火山方舟还需要在控制台开通对应的视频模型。
智谱的图像、视频模型默认会在画面右下角加「AI生成」水印,需要在智谱控制台签署免责声明后才能去掉;剧照作为视频第一帧时,水印也会带进视频。不想要水印时,出剧照可以用通义万相(默认不带水印)。
2.2 视频参数
页面上可选的分辨率、单个镜头的秒数和预估费用,都取自视频模型。没有填写视频参数时使用以下默认值:
| 模型 | 分辨率 | 单个镜头时长 | 参考单价(元/秒) | 声音 |
|---|---|---|---|---|
| 火山方舟 Seedance 2.x | 480p、720p(默认)、1080p | 4~30 秒 | 0.68 / 1.51 / 3.40 | 可开关,开启后生成对白和音效 |
| MiniMax-H3 | 768P(默认)、2K | 4~15 秒 | 0.50 / 0.80 | 固定带声音 |
| MiniMax-H3-Max | 480P、768P(默认) | 5~15 秒 | 0.33 / 0.50 | 固定带声音 |
| 智谱 CogVideoX / Vidu | 720p、1080p(默认)、4K | 只能 5 秒或 10 秒 | 按次计费,没有内置(见下方说明) | 可开关 |
单价是参考价,只用于页面上的费用预估,实际费用以供应商账单为准。供应商调价后,可以在视频参数里改成最新的价格。
智谱的视频是按次计费的(每生成一个视频收一次费,和秒数无关),而系统的预估是按「秒数 × 每秒单价」算的,所以没有内置智谱的单价:不填时页面上不显示预估费用,「累计费用」也不累加。需要预估时,在视频参数的 price 里按「每次价格 ÷ 镜头秒数」填写,比如每次 1 元、镜头都是 5 秒,就填 0.2。
需要调整时,点击「视频参数」右侧的按钮填写 JSON,没写的项保持默认值。例如只开放 480p 和 720p,每个镜头默认 5 秒:
{
  "resolutions": ["480p", "720p"],
  "defaultResolution": "720p",
  "minDuration": 4,
  "maxDuration": 15,
  "defaultDuration": 5,
  "price": { "480p": 0.68, "720p": 1.51 }
}
| 参数 | 说明 |
|---|---|
| resolutions | 可选的分辨率,写法与供应商一致(火山方舟、智谱用小写 p,MiniMax 用大写 P) |
| defaultResolution | 默认分辨率 |
| minDuration / maxDuration | 单个镜头最短、最长秒数 |
| durations | 只能取固定几个秒数时填写,如智谱 [5, 10];填了它,最短、最长按它的两端计算 |
| defaultDuration | 新增镜头时的默认秒数 |
| price | 各分辨率的单价(元/秒),用于费用预估;没有填写的分辨率不显示预估费用 |
3. 制作一个动漫短片
下面以「橘猫与时间齿轮」为例,演示从剧本到视频的完整过程:3 个镜头,每个镜头 5 秒。每一步都附上了本例填写的提示词和生成效果,可以对照着看。
3.1 新建作品
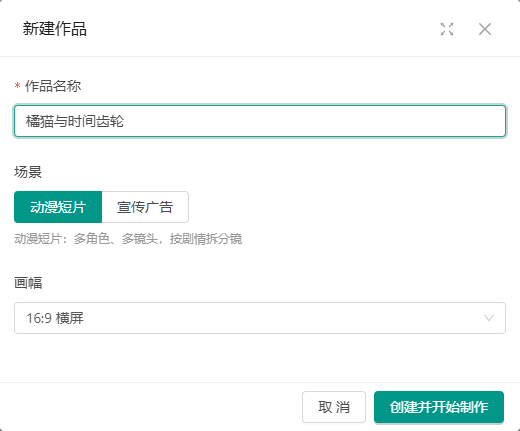
进入「AI应用 → AI工具箱 → AI动漫视频」,点击「新建作品」:
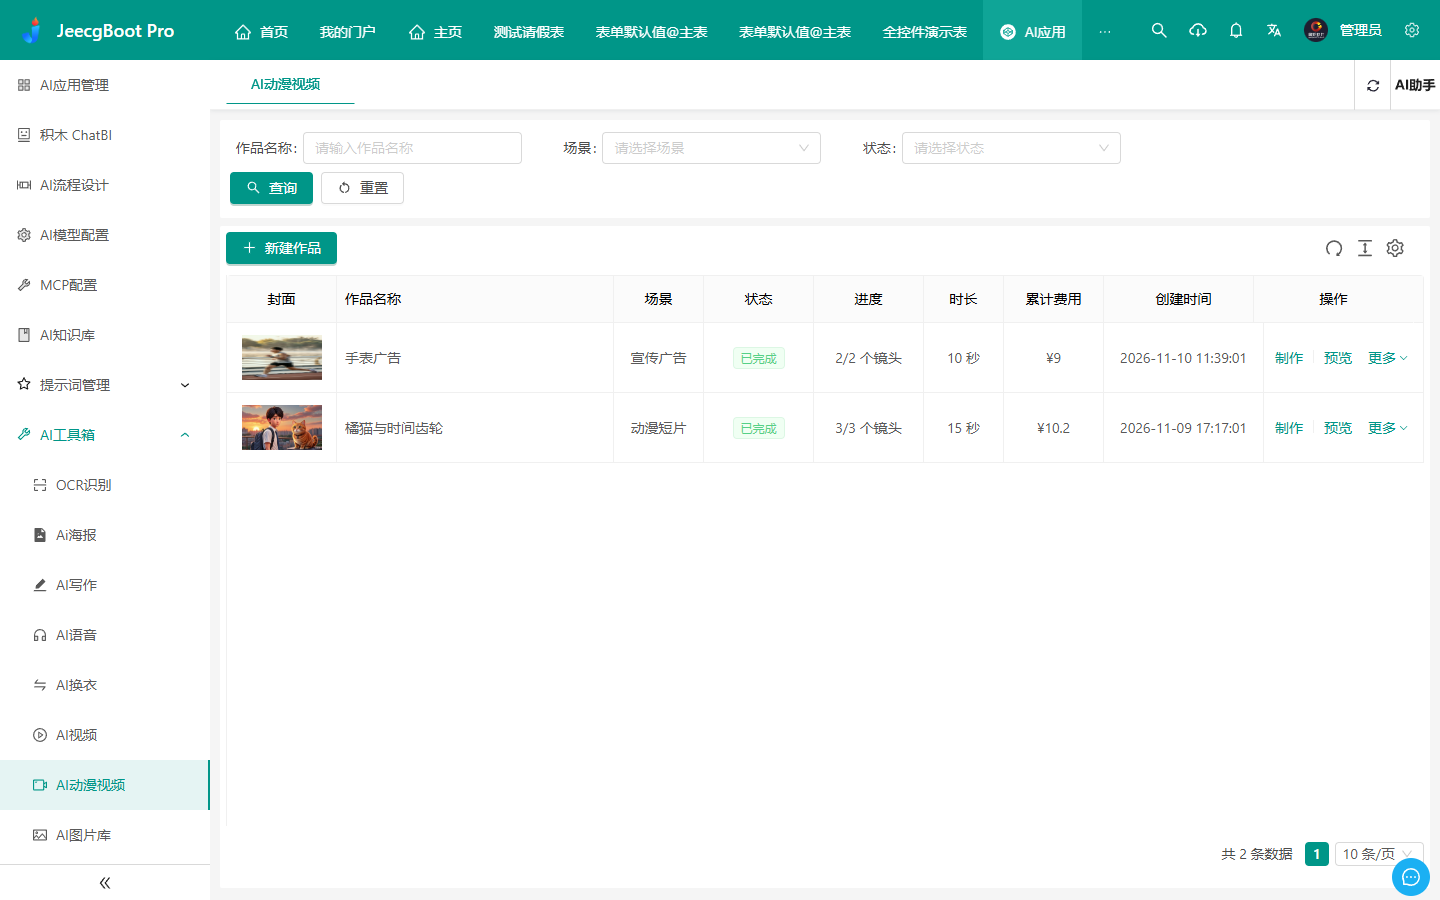
填写作品名称,选择场景和画幅,点击「创建并开始制作」:
- 场景:
- 动漫短片:多角色、多镜头,按剧情拆分镜,默认 16:9 横屏
- 宣传广告:开头抓眼球、中间讲卖点、结尾行动号召,默认 9:16 竖屏(见 第 4 节)
- 画幅:16:9 横屏、9:16 竖屏、1:1 方形、4:3、3:4
3.2 填写剧本和作品设置
创建后自动打开制作页面,左侧是作品设置和角色,右侧是分镜:
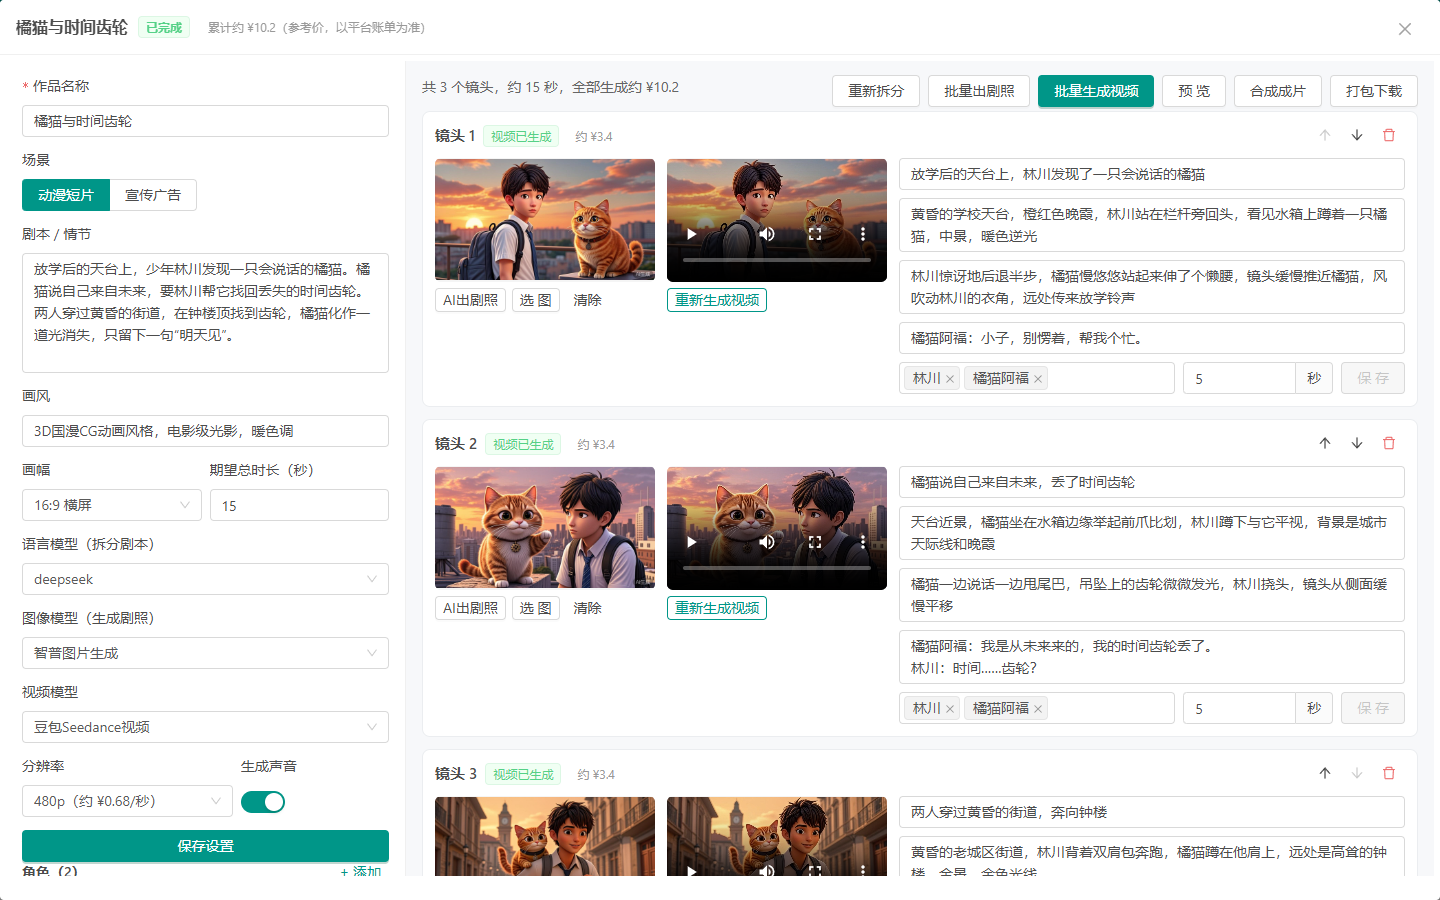
在左侧填写作品设置:
| 设置 | 说明 | 示例 |
|---|---|---|
| 剧本 / 情节 | 故事梗概;宣传广告填写产品卖点、目标人群和口号 | 放学后的天台上,少年林川发现一只会说话的橘猫…… |
| 画风 | 全片统一的画风,会带进每个镜头;不填由 AI 决定 | 3D国漫CG动画风格,电影级光影,暖色调 |
| 画幅 | 新建时选的画幅,可以修改 | 16:9 横屏 |
| 期望总时长(秒) | AI 拆分时让所有镜头加起来尽量接近这个时长 | 15 |
| 语言模型(拆分剧本) | 用来拆分剧本 | deepseek |
| 图像模型(生成剧照) | 用来生成剧照,不出剧照可以不选 | 智普图片生成 |
| 视频模型 | 用来生成视频 | 豆包Seedance视频 |
| 分辨率 | 按视频模型列出可选分辨率和单价 | 480p(约 ¥0.68/秒) |
| 生成声音 | 打开后对白和音效由视频模型生成,台词会写进提示词;MiniMax 固定带声音,不能切换 | 打开 |
分辨率下方会提示当前视频模型单个镜头允许的时长,例如「单个镜头4~30 秒」。
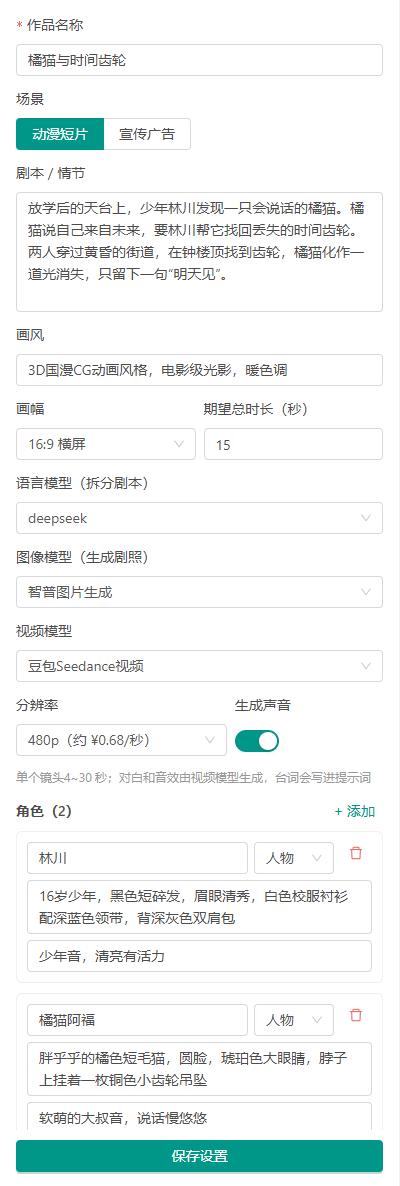
角色:AI 拆分剧本时会自动整理角色,也可以点击「+ 添加」手动添加。每个角色包括:
- 名称和类型(人物 / 商品)
- 固定外貌:发型发色、五官、服装配色、体型、配饰。外貌描述会原样带进每个镜头的提示词,写得越具体,前后镜头里的人物越一致
- 音色:如「少年音,清亮有活力」(商品没有音色)
本例的两个角色(外貌和音色会自动带进每个镜头的提示词):
| 角色 | 固定外貌 | 音色 |
|---|---|---|
| 林川 | 16岁少年,黑色短碎发,眉眼清秀,白色校服衬衫配深蓝色领带,背深灰色双肩包 | 少年音,清亮有活力 |
| 橘猫阿福 | 胖乎乎的橘色短毛猫,圆脸,琥珀色大眼睛,脖子上挂着一枚铜色小齿轮吊坠 | 软萌的大叔音,说话慢悠悠 |
填好后点击「保存设置」。关闭制作页面时,如果有没保存的设置也会自动保存。
3.3 AI拆分剧本
点击右侧上方的「AI拆分剧本」,AI 会根据剧本整理出角色和分镜,通常需要 30 秒到 2 分钟。拆分前需要先选好语言模型和视频模型(镜头时长范围取自视频模型)。
拆分结果:
- 角色:名称、固定外貌、音色
- 分镜:最多 30 个镜头,每个镜头包括情节、剧照画面、动作和运镜、台词、出场角色和时长,时长都在视频模型允许的范围内
本例的剧本:
放学后的天台上,少年林川发现一只会说话的橘猫。橘猫说自己来自未来,要林川帮它找回丢失的时间齿轮。两人穿过黄昏的街道,在钟楼顶找到齿轮,橘猫化作一道光消失,只留下一句“明天见”。
本例最终使用的 3 个镜头如下(拆分后可以逐个修改),后面出剧照、生成视频都基于这些内容:
| 镜头 | 情节 | 出场角色 | 时长 |
|---|---|---|---|
| 1 | 放学后的天台上,林川发现了一只会说话的橘猫 | 林川、橘猫阿福 | 5 秒 |
| 2 | 橘猫说自己来自未来,丢了时间齿轮 | 林川、橘猫阿福 | 5 秒 |
| 3 | 两人穿过黄昏的街道,奔向钟楼 | 林川、橘猫阿福 | 5 秒 |
拆分只调用语言模型,不会生成视频。
已经有分镜时按钮变为「重新拆分」,重新拆分会删除现有的全部镜头(已生成的剧照还在图片库里)。
3.4 检查和修改分镜
每个镜头是一张分镜卡片,生成之前建议逐个检查一遍:
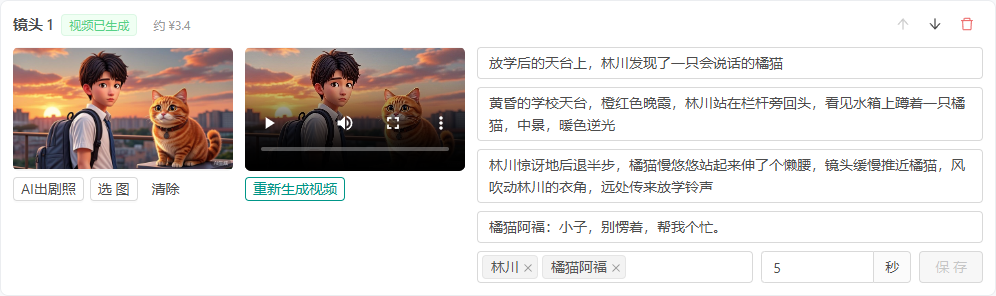
| 内容 | 说明 |
|---|---|
| 标题栏 | 镜头序号、状态、按当前分辨率估算的费用;右侧可以上移、下移、删除镜头 |
| 剧照 | 镜头开头那一帧的画面,生成视频时作为首帧;没有剧照时直接文生视频 |
| 视频 | 生成好的分镜视频,可以直接播放 |
| 情节 | 这个镜头发生了什么 |
| 剧照画面 | 场景、光线、人物位置、动作表情、构图,用来生成剧照 |
| 动作和运镜 | 人物动作变化、镜头推拉摇移、环境音效,用来生成视频 |
| 台词 | 每行一句,格式「角色名:台词」,没有可以留空;按每秒约 4 个字估算,不要超出镜头时长 |
| 出场角色 | 这个镜头里出现的角色,生成时会带上他们的外貌描述 |
| 时长 | 单位秒,要在视频模型允许的范围内,本例填 5 秒 |
修改后点击卡片上的「保存」。点击分镜列表底部的「+ 添加镜头」可以手动增加镜头。
智谱的视频模型只支持 5 秒或 10 秒。选了智谱视频模型时,时长下方会提示「智谱视频模型的时长只能是 5、10 秒」,填了其他秒数,生成视频时会提示先修改。
3.5 生成剧照(可选)
剧照决定了视频第一帧的画面。先出剧照,满意后再生成视频,可以减少视频返工(视频比图片贵得多)。
- 单个镜头:点击剧照下方的「AI出剧照」
- 全部镜头:点击右侧上方的「批量出剧照」
- 从图片库选:点击「选图」,从 AI图片库中选择一张;也可以点列表第一格的「上传图片」上传新图片,上传后直接选中
- 清除:去掉剧照,直接文生视频
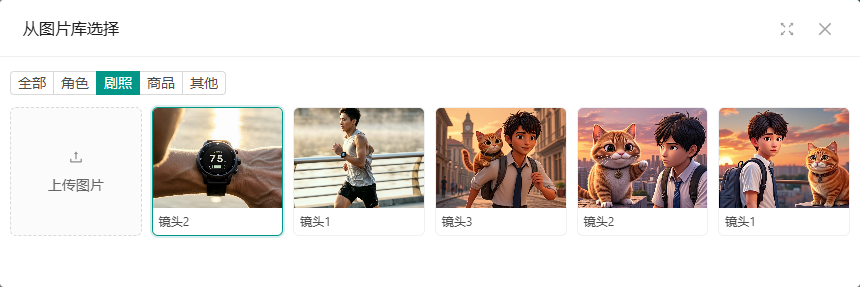
AI 生成的剧照会自动保存到 AI图片库。
本例效果
页面上只需要写「剧照画面」。生成剧照时,系统会自动在前面加上画风、在后面加上出场角色的固定外貌,再交给图像模型。下面是每个镜头填写的内容、实际提交的提示词和生成的剧照(本例图像模型用的是智普图片生成,所以右下角带「AI生成」水印;第 4 节的广告用通义万相,没有水印):
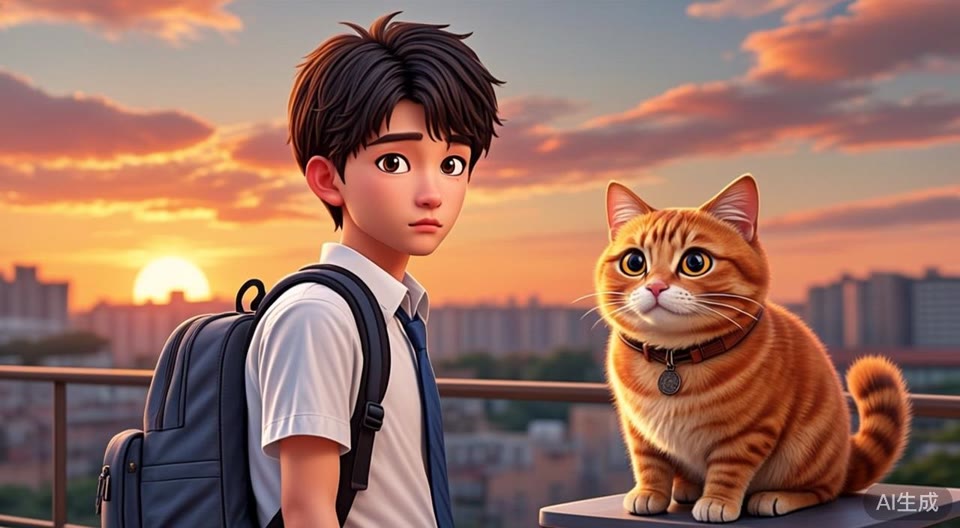
镜头 1:放学后的天台上,林川发现了一只会说话的橘猫
- 剧照画面:黄昏的学校天台,橙红色晚霞,林川站在栏杆旁回头,看见水箱上蹲着一只橘猫,中景,暖色逆光
- 出场角色:林川、橘猫阿福
实际提交给图像模型的提示词
画风:3D国漫CG动画风格,电影级光影,暖色调。黄昏的学校天台,橙红色晚霞,林川站在栏杆旁回头,看见水箱上蹲着一只橘猫,中景,暖色逆光。画面中的人物:林川(16岁少年,黑色短碎发,眉眼清秀,白色校服衬衫配深蓝色领带,背深灰色双肩包);橘猫阿福(胖乎乎的橘色短毛猫,圆脸,琥珀色大眼睛,脖子上挂着一枚铜色小齿轮吊坠)。
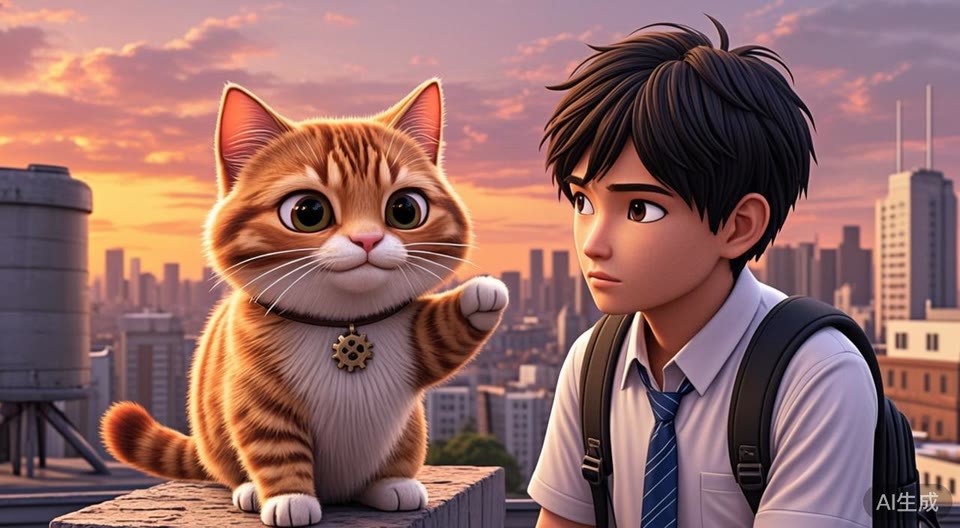
镜头 2:橘猫说自己来自未来,丢了时间齿轮
- 剧照画面:天台近景,橘猫坐在水箱边缘举起前爪比划,林川蹲下与它平视,背景是城市天际线和晚霞
- 出场角色:林川、橘猫阿福
实际提交给图像模型的提示词
画风:3D国漫CG动画风格,电影级光影,暖色调。天台近景,橘猫坐在水箱边缘举起前爪比划,林川蹲下与它平视,背景是城市天际线和晚霞。画面中的人物:林川(16岁少年,黑色短碎发,眉眼清秀,白色校服衬衫配深蓝色领带,背深灰色双肩包);橘猫阿福(胖乎乎的橘色短毛猫,圆脸,琥珀色大眼睛,脖子上挂着一枚铜色小齿轮吊坠)。
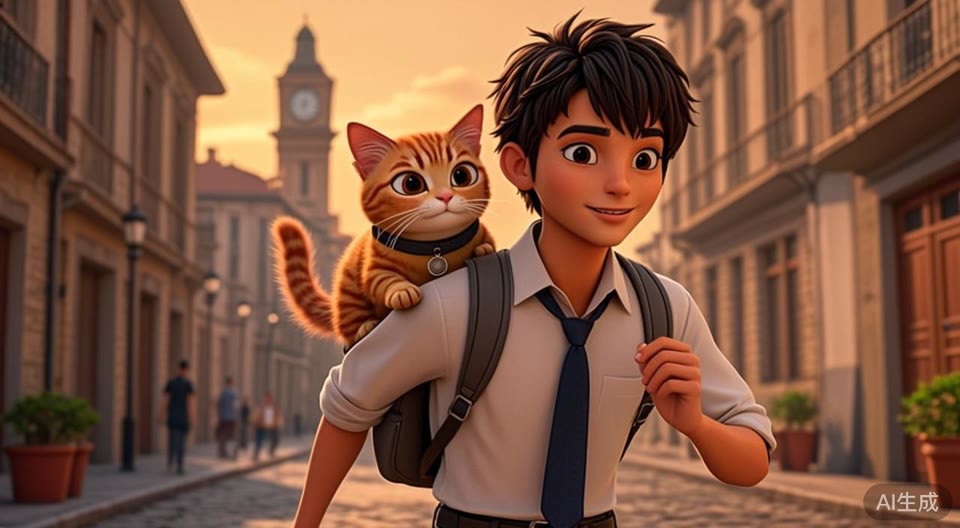
镜头 3:两人穿过黄昏的街道,奔向钟楼
- 剧照画面:黄昏的老城区街道,林川背着双肩包奔跑,橘猫蹲在他肩上,远处是高耸的钟楼,全景,金色光线
- 出场角色:林川、橘猫阿福
实际提交给图像模型的提示词
画风:3D国漫CG动画风格,电影级光影,暖色调。黄昏的老城区街道,林川背着双肩包奔跑,橘猫蹲在他肩上,远处是高耸的钟楼,全景,金色光线。画面中的人物:林川(16岁少年,黑色短碎发,眉眼清秀,白色校服衬衫配深蓝色领带,背深灰色双肩包);橘猫阿福(胖乎乎的橘色短毛猫,圆脸,琥珀色大眼睛,脖子上挂着一枚铜色小齿轮吊坠)。
3.6 生成视频
- 单个镜头:点击视频下方的「生成视频」(已经生成过的显示「重新生成视频」)
- 全部镜头:点击右侧上方的「批量生成视频」,提交所有还没有视频的镜头
提交前会弹窗显示镜头数、总秒数、分辨率和预估费用,点击「确定生成」后才会提交:
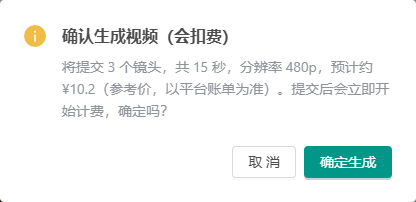
本例 3 个镜头,每个 5 秒,480p:3 × 5 秒 × 0.68 元/秒 ≈ 10.2 元。
已经生成过视频的镜头再次生成,会重新扣费。
提交后镜头状态变为「视频生成中」,通常 1~5 分钟出片。视频在后台生成,可以关闭页面,稍后再回来查看;制作页面打开时每 5 秒自动刷新一次状态。
| 状态 | 说明 |
|---|---|
| 待生成 | 还没有出剧照和视频 |
| 剧照生成中 / 剧照已生成 | 正在出剧照 / 剧照已出好 |
| 视频生成中 | 已提交到视频模型,等待出片 |
| 视频已生成 | 视频已保存,可以播放 |
| 失败 | 卡片下方显示失败原因 |
本例效果
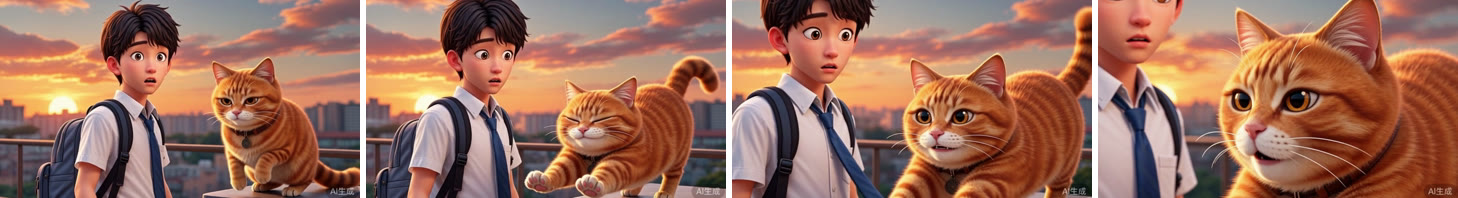
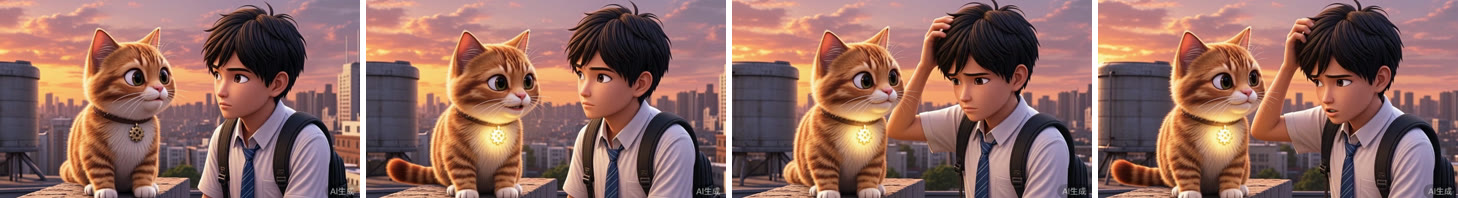
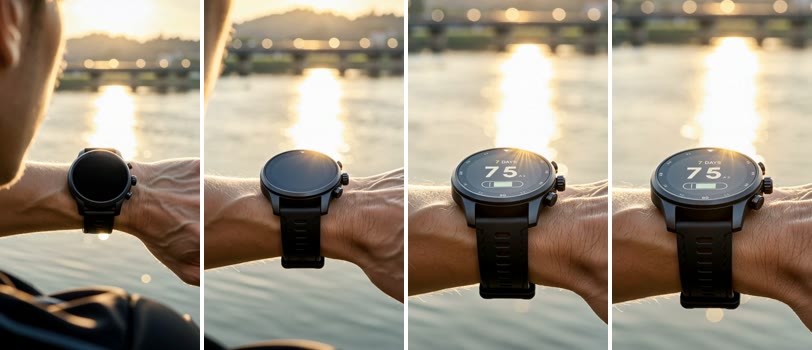
页面上写「动作和运镜」和「台词」。生成视频时,系统会自动加上画风和出场角色的固定外貌,台词前面带上角色的音色(打开「生成声音」时才带台词);镜头有剧照时,剧照作为视频的第一帧。下面是每个镜头填写的内容、实际提交的提示词和生成的视频(每段视频截了 4 帧,从左到右依次是第 0.6、1.9、3.2、4.4 秒的画面):
镜头 1:放学后的天台上,林川发现了一只会说话的橘猫(5 秒)
- 动作和运镜:林川惊讶地后退半步,橘猫慢悠悠站起来伸了个懒腰,镜头缓慢推近橘猫,风吹动林川的衣角,远处传来放学铃声
- 台词:橘猫阿福:小子,别愣着,帮我个忙。
- 第一帧:上一步生成的镜头 1 剧照
实际提交给视频模型的提示词
画风:3D国漫CG动画风格,电影级光影,暖色调。林川惊讶地后退半步,橘猫慢悠悠站起来伸了个懒腰,镜头缓慢推近橘猫,风吹动林川的衣角,远处传来放学铃声。
出场人物:林川(16岁少年,黑色短碎发,眉眼清秀,白色校服衬衫配深蓝色领带,背深灰色双肩包);橘猫阿福(胖乎乎的橘色短毛猫,圆脸,琥珀色大眼睛,脖子上挂着一枚铜色小齿轮吊坠)。
台词(请配音并对上口型):
橘猫阿福(软萌的大叔音,说话慢悠悠)说:“小子,别愣着,帮我个忙。”
镜头 2:橘猫说自己来自未来,丢了时间齿轮(5 秒)
- 动作和运镜:橘猫一边说话一边甩尾巴,吊坠上的齿轮微微发光,林川挠头,镜头从侧面缓慢平移
- 台词:
- 橘猫阿福:我是从未来来的,我的时间齿轮丢了。
- 林川:时间……齿轮?
- 第一帧:上一步生成的镜头 2 剧照
实际提交给视频模型的提示词
画风:3D国漫CG动画风格,电影级光影,暖色调。橘猫一边说话一边甩尾巴,吊坠上的齿轮微微发光,林川挠头,镜头从侧面缓慢平移。
出场人物:林川(16岁少年,黑色短碎发,眉眼清秀,白色校服衬衫配深蓝色领带,背深灰色双肩包);橘猫阿福(胖乎乎的橘色短毛猫,圆脸,琥珀色大眼睛,脖子上挂着一枚铜色小齿轮吊坠)。
台词(请配音并对上口型):
橘猫阿福(软萌的大叔音,说话慢悠悠)说:“我是从未来来的,我的时间齿轮丢了。”
林川(少年音,清亮有活力)说:“时间……齿轮?”
镜头 3:两人穿过黄昏的街道,奔向钟楼(5 秒)
- 动作和运镜:林川沿街奔跑,橘猫抓紧书包带,镜头跟随移动,街边灯笼依次亮起,脚步声和风声
- 台词:无
- 第一帧:上一步生成的镜头 3 剧照
实际提交给视频模型的提示词
画风:3D国漫CG动画风格,电影级光影,暖色调。林川沿街奔跑,橘猫抓紧书包带,镜头跟随移动,街边灯笼依次亮起,脚步声和风声。
出场人物:林川(16岁少年,黑色短碎发,眉眼清秀,白色校服衬衫配深蓝色领带,背深灰色双肩包);橘猫阿福(胖乎乎的橘色短毛猫,圆脸,琥珀色大眼睛,脖子上挂着一枚铜色小齿轮吊坠)。
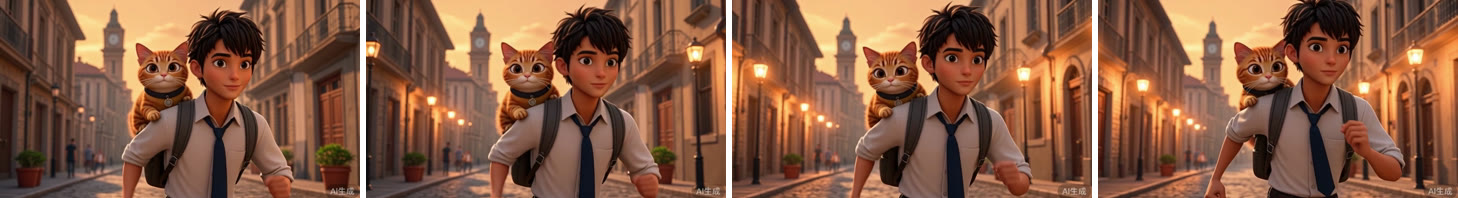
3.7 预览、合成成片和下载
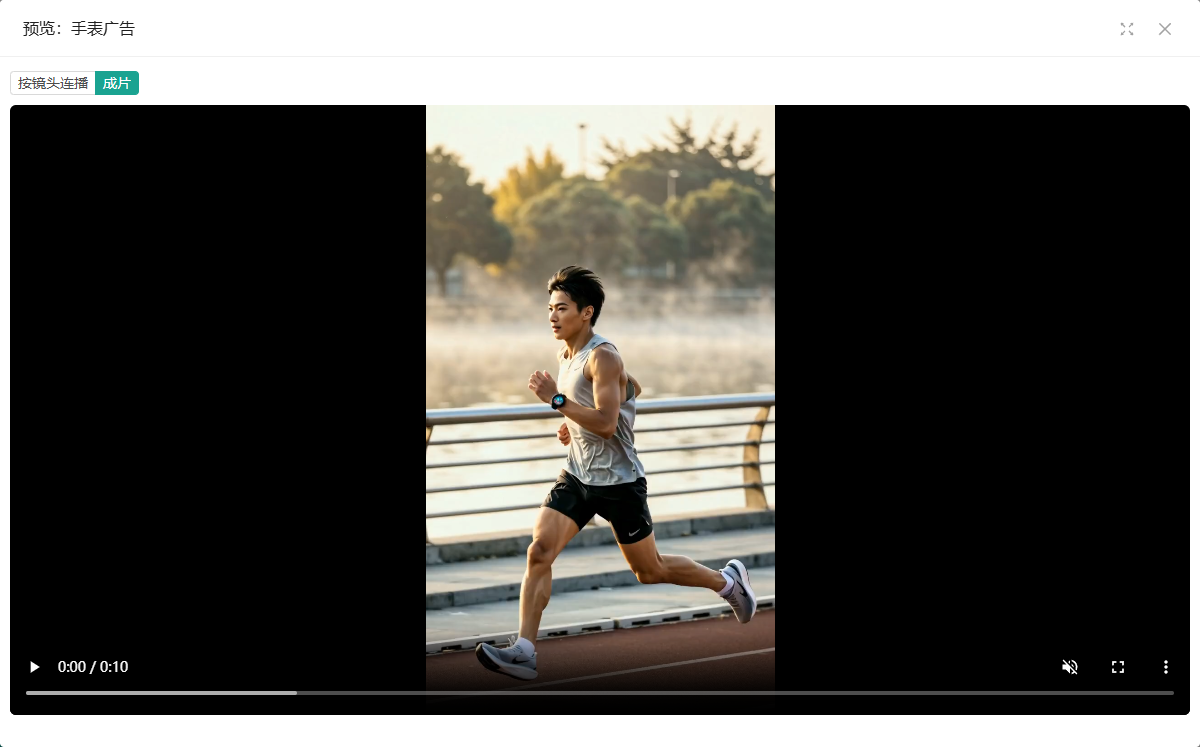
- 预览:按镜头顺序连续播放所有分镜视频;合成过成片后,可以切换到「成片」观看
- 合成成片:所有镜头都生成好视频后,点击「合成成片」,把各镜头按顺序拼成一个 mp4 文件。合成在后台进行,通常几秒到一两分钟,期间作品状态是「合成中」
- 打包下载:下载一个 zip 文件,里面有成片
00_成片.mp4(合成过才有)和按镜头顺序编号的分镜 mp4,分镜文件名为「序号_情节」
合成时会统一各镜头的音量,没有声音的镜头会补上静音;各镜头格式不一致,或者是 Seedance 1080p 的 10bit H.265 时,会统一转成 H.264,浏览器都能直接播放。
合成需要服务器安装 ffmpeg。没有安装时「合成成片」按钮是灰的,鼠标移上去有提示,这时可以打包下载后用剪辑工具拼接。
重新生成某个镜头的视频、删除镜头、添加镜头或调整镜头顺序后,旧成片会作废,需要重新合成。
本例效果
3 个镜头合成后约 15 秒,对应 3.3 中的剧本。
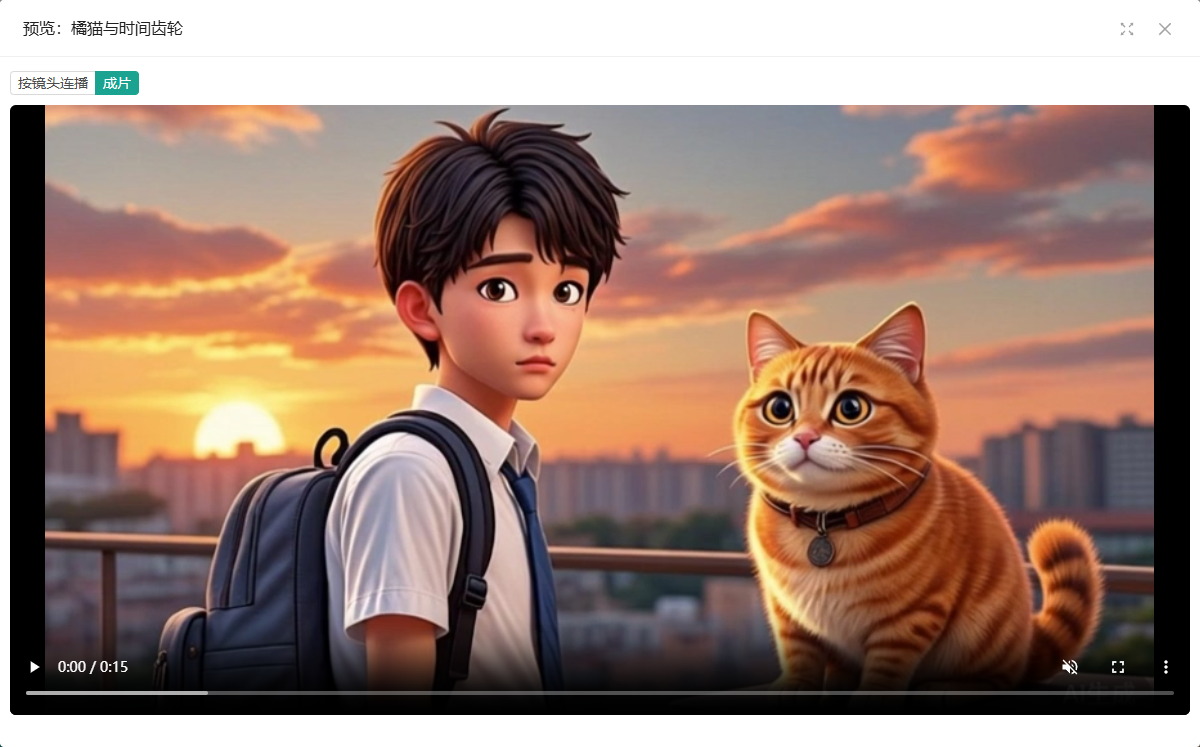
在作品列表中也可以直接「预览」,「更多」里有「打包下载」和「删除」。删除作品会同时删除它的分镜,图片库里的图片会保留。
4. 制作宣传广告
新建作品时场景选择「宣传广告」(默认 9:16 竖屏),在「产品 / 品牌信息」里写产品和卖点,例如:
一款主打 7 天续航的运动手表。卖点:超长续航、50 米防水、心率血氧监测。目标人群:喜欢户外跑步的年轻人。结尾口号:“跑得更远,不必回头充电”。
AI 会按广告的节奏拆分镜:开头 3 秒内抓住注意力,中间展示 2~3 个核心卖点和使用场景,结尾给出品牌、口号和行动号召,台词以旁白或口播为主。角色中可以添加「商品」类型,在外貌里写清商品本身的外观、颜色、材质和 logo 位置。也可以像下面的例子一样,直接把想要的画面写成分镜脚本,AI 会按脚本拆分。其余步骤与动漫短片相同。
4.1 本例:手表广告
下面以「手表广告」为例:2 个镜头,共约 10 秒。图像模型用通义万相 wan2.2,剧照不带水印;视频模型用 MiniMax-H3。
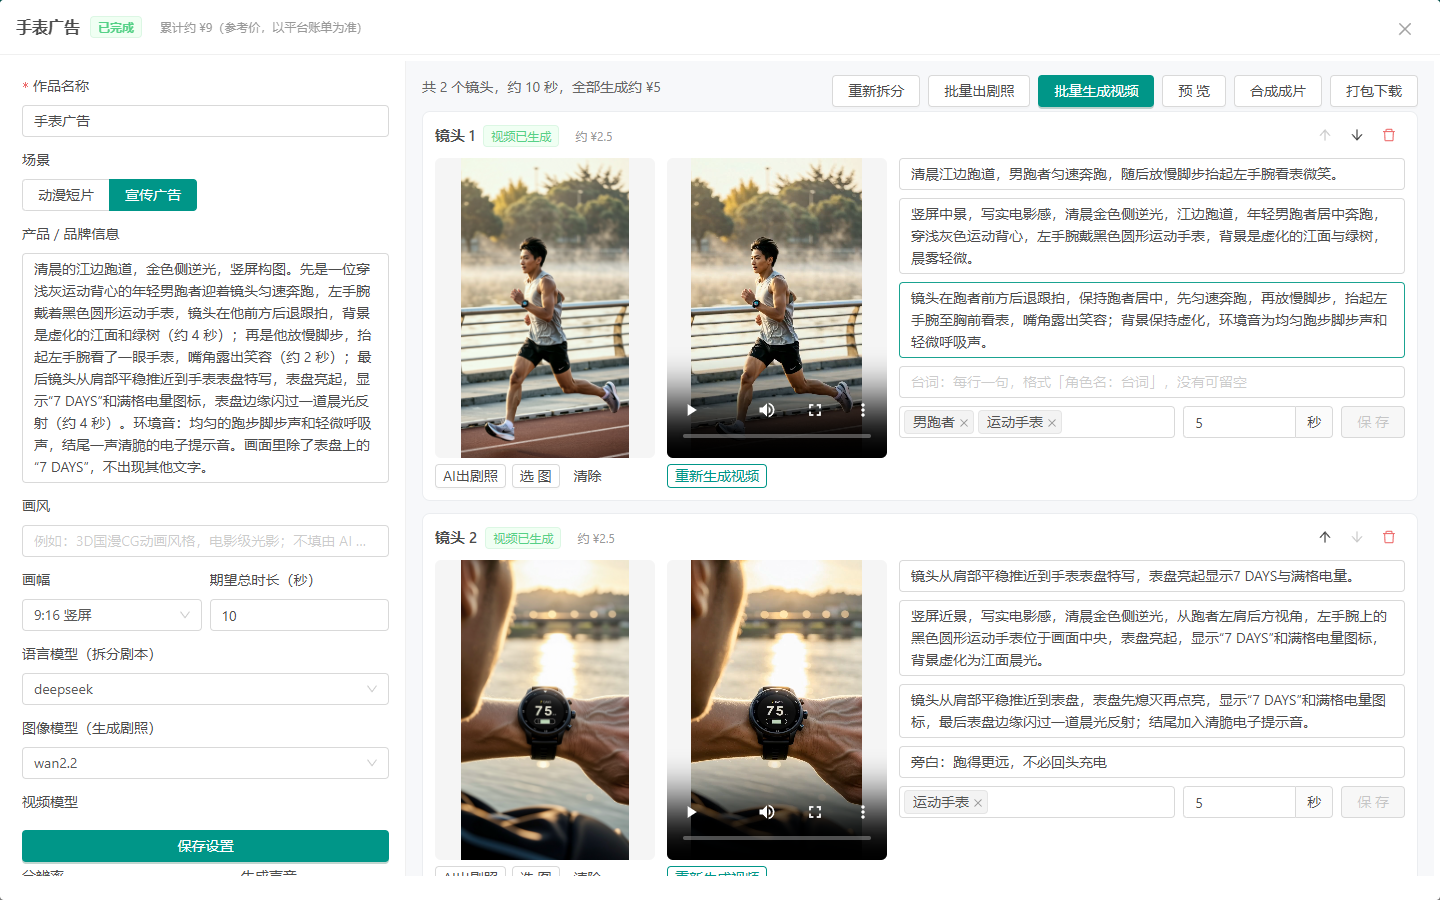
本例的产品 / 品牌信息(直接写成了分镜脚本):
清晨的江边跑道,金色侧逆光,竖屏构图。先是一位穿浅灰运动背心的年轻男跑者迎着镜头匀速奔跑,左手腕戴着黑色圆形运动手表,镜头在他前方后退跟拍,背景是虚化的江面和绿树(约 4 秒);再是他放慢脚步,抬起左手腕看了一眼手表,嘴角露出笑容(约 2 秒);最后镜头从肩部平稳推近到手表表盘特写,表盘亮起,显示“7 DAYS”和满格电量图标,表盘边缘闪过一道晨光反射(约 4 秒)。环境音:均匀的跑步脚步声和轻微呼吸声,结尾一声清脆的电子提示音。画面里除了表盘上的“7 DAYS”,不出现其他文字。
| 设置 | 本例 |
|---|---|
| 画幅 | 9:16 竖屏 |
| 期望总时长(秒) | 10 |
| 语言模型(拆分剧本) | deepseek |
| 图像模型(生成剧照) | wan2.2(通义万相) |
| 视频模型 | MiniMax-H3 |
| 分辨率 | 768P(约 ¥0.5/秒) |
| 生成声音 | 打开(MiniMax 固定带声音) |
AI 拆分出的角色。手表是「商品」类型,生成时单独作为商品描述,不会被当成另一个人物:
| 角色 | 固定外貌 | 音色 |
|---|---|---|
| 男跑者(人物) | 黑色短发,五官清瘦立体,小麦肤色;穿浅灰色无袖运动背心、黑色运动短裤和灰白色跑鞋,体型精瘦有肌肉线条;左手腕戴黑色圆形运动手表。 | 青年男声,干净有活力 |
| 运动手表(商品) | 黑色圆形表盘,表盘玻璃清透反光,表壳为哑光黑金属,配黑色硅胶表带;表盘下方有细微品牌标识位置,整体极简运动风。 | 无 |
脚本里写了三段(约 4 秒、2 秒、4 秒),而 MiniMax-H3 每个镜头最短 4 秒,2 秒的「放慢脚步、抬腕看表」一段就并进了镜头 1,所以拆成 2 个镜头、每个 5 秒。镜头 2 的台词「旁白:跑得更远,不必回头充电」是拆分后手动加的。
想让 AI 按你写的分段出镜头,每段时长不要短于视频模型的最短时长(火山方舟 Seedance 2.x、MiniMax-H3 是 4 秒,智谱是 5 秒)。
4.2 本例效果
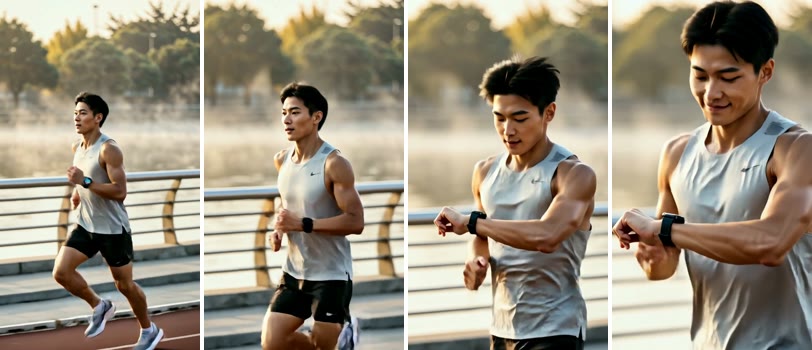
每个镜头填写的内容、实际提交给模型的提示词、生成的剧照和视频截帧(从左到右按时间先后)如下:
镜头 1:清晨江边跑道,男跑者匀速奔跑,随后放慢脚步抬起左手腕看表微笑。(5 秒)
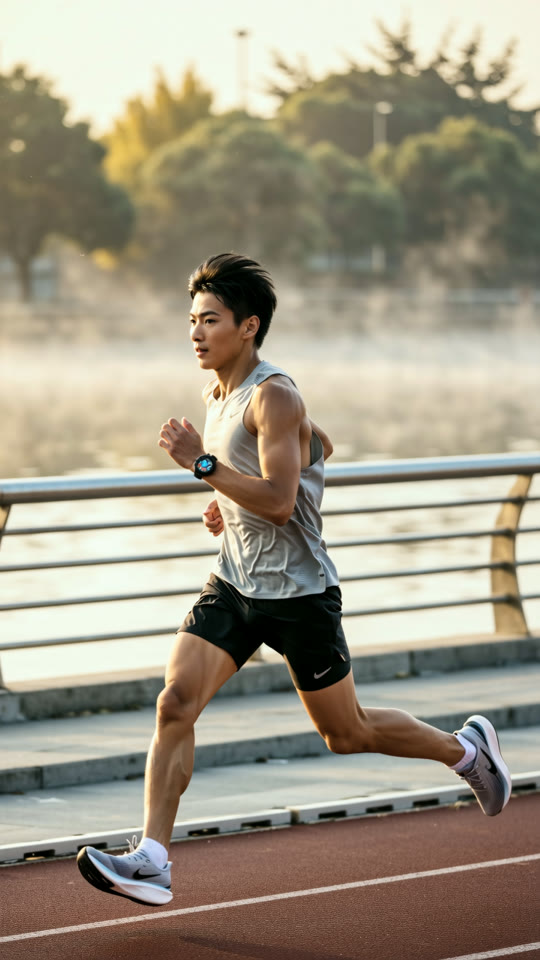
- 剧照画面:竖屏中景,写实电影感,清晨金色侧逆光,江边跑道,年轻男跑者居中奔跑,穿浅灰色运动背心,左手腕戴黑色圆形运动手表,背景是虚化的江面与绿树,晨雾轻微。
- 动作和运镜:镜头在跑者前方后退跟拍,保持跑者居中,先匀速奔跑,再放慢脚步,抬起左手腕至胸前看表,嘴角露出笑容;背景保持虚化,环境音为均匀跑步脚步声和轻微呼吸声。
- 台词:无
- 出场角色:男跑者、运动手表
实际提交给图像模型的提示词
竖屏中景,写实电影感,清晨金色侧逆光,江边跑道,年轻男跑者居中奔跑,穿浅灰色运动背心,左手腕戴黑色圆形运动手表,背景是虚化的江面与绿树,晨雾轻微。画面中的人物:男跑者(黑色短发,五官清瘦立体,小麦肤色;穿浅灰色无袖运动背心、黑色运动短裤和灰白色跑鞋,体型精瘦有肌肉线条;左手腕戴黑色圆形运动手表。)。画面中的商品:运动手表(黑色圆形表盘,表盘玻璃清透反光,表壳为哑光黑金属,配黑色硅胶表带;表盘下方有细微品牌标识位置,整体极简运动风。)。
实际提交给视频模型的提示词
镜头在跑者前方后退跟拍,保持跑者居中,先匀速奔跑,再放慢脚步,抬起左手腕至胸前看表,嘴角露出笑容;背景保持虚化,环境音为均匀跑步脚步声和轻微呼吸声。
出场人物:男跑者(黑色短发,五官清瘦立体,小麦肤色;穿浅灰色无袖运动背心、黑色运动短裤和灰白色跑鞋,体型精瘦有肌肉线条;左手腕戴黑色圆形运动手表。)。出场商品:运动手表(黑色圆形表盘,表盘玻璃清透反光,表壳为哑光黑金属,配黑色硅胶表带;表盘下方有细微品牌标识位置,整体极简运动风。)。
剧照:
视频截帧:
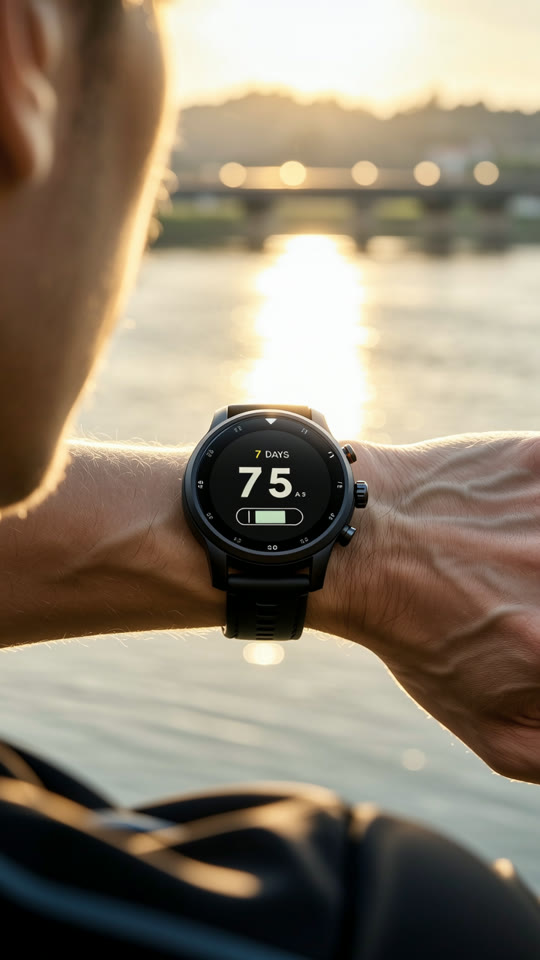
镜头 2:镜头从肩部平稳推近到手表表盘特写,表盘亮起显示7 DAYS与满格电量。(5 秒)
- 剧照画面:竖屏近景,写实电影感,清晨金色侧逆光,从跑者左肩后方视角,左手腕上的黑色圆形运动手表位于画面中央,表盘亮起,显示“7 DAYS”和满格电量图标,背景虚化为江面晨光。
- 动作和运镜:镜头从肩部平稳推近到表盘,表盘先熄灭再点亮,显示“7 DAYS”和满格电量图标,最后表盘边缘闪过一道晨光反射;结尾加入清脆电子提示音。
- 台词:旁白:跑得更远,不必回头充电
- 出场角色:运动手表
实际提交给图像模型的提示词
竖屏近景,写实电影感,清晨金色侧逆光,从跑者左肩后方视角,左手腕上的黑色圆形运动手表位于画面中央,表盘亮起,显示“7 DAYS”和满格电量图标,背景虚化为江面晨光。画面中的商品:运动手表(黑色圆形表盘,表盘玻璃清透反光,表壳为哑光黑金属,配黑色硅胶表带;表盘下方有细微品牌标识位置,整体极简运动风。)。
实际提交给视频模型的提示词
镜头从肩部平稳推近到表盘,表盘先熄灭再点亮,显示“7 DAYS”和满格电量图标,最后表盘边缘闪过一道晨光反射;结尾加入清脆电子提示音。
出场商品:运动手表(黑色圆形表盘,表盘玻璃清透反光,表壳为哑光黑金属,配黑色硅胶表带;表盘下方有细微品牌标识位置,整体极简运动风。)。
台词(请配音并对上口型):
旁白说:“跑得更远,不必回头充电”
剧照:
视频截帧:
两个镜头合成后的成片约 10 秒:
5. AI图片库
「AI应用 → AI工具箱 → AI图片库」集中管理剧照和素材。AI 生成的剧照会自动保存到这里,也可以上传自己的图片,在分镜中通过「选图」使用。
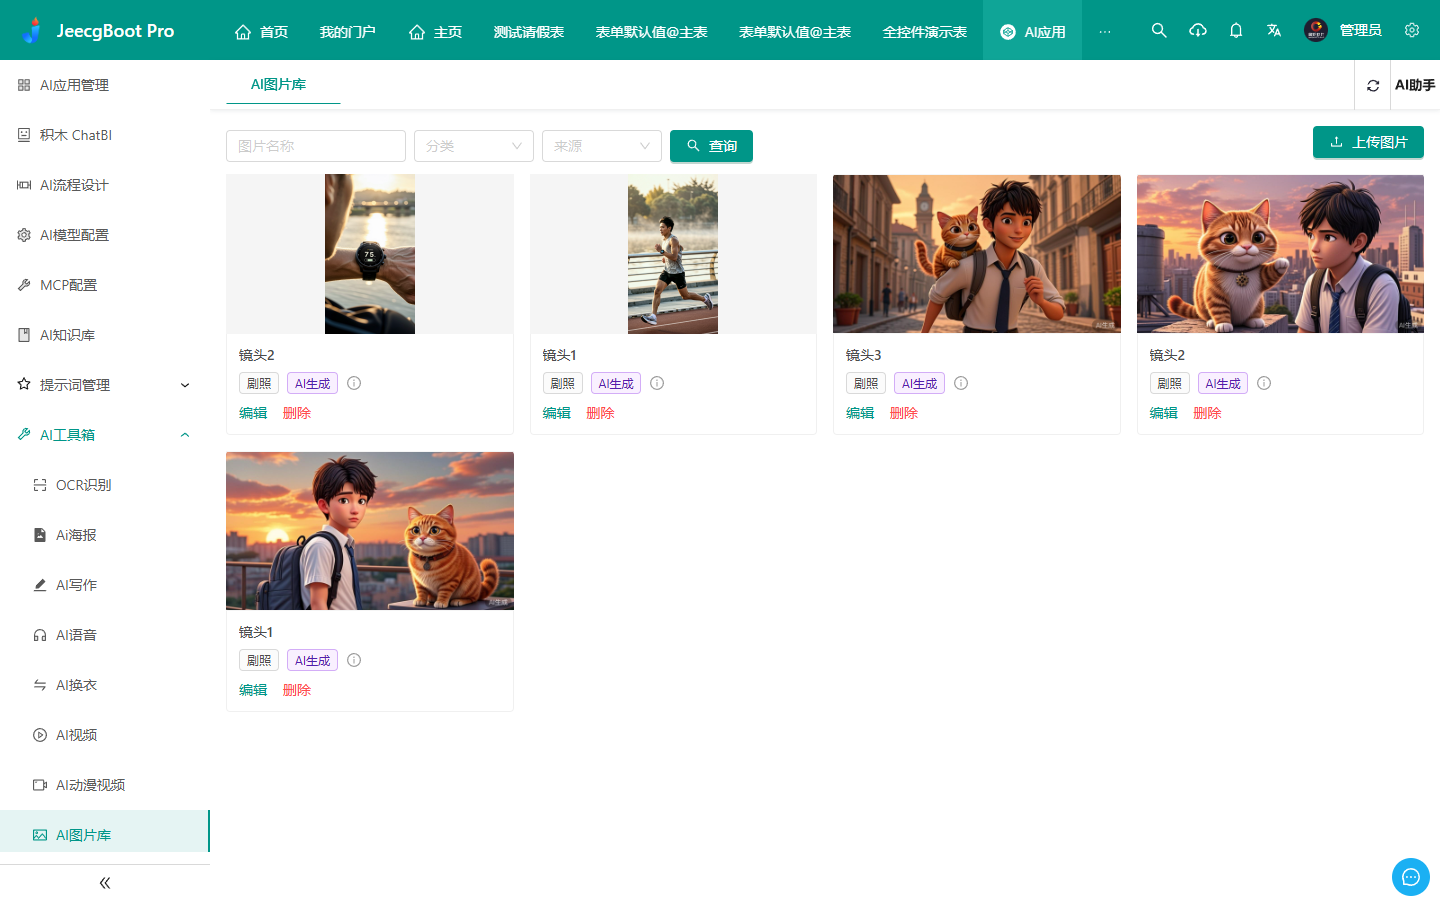
可以按名称、分类、来源(上传 / AI生成)筛选。点击「上传图片」,可以一次上传多张,填写名称并选择分类(角色、剧照、商品、其他):
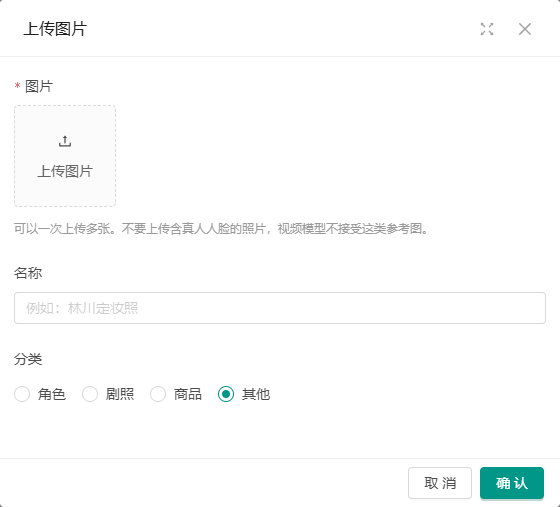
不要上传含真人人脸的照片,视频模型不接受这类参考图。
6. 权限说明
系统升级后,admin 和已经有「AI工具箱」菜单权限的角色会自动获得授权;其他角色需要在「系统管理 → 角色管理」中授权:
| 菜单 | 按钮 | 权限编码 |
|---|---|---|
| AI动漫视频 | 查看作品 | airag:video:project:list |
| 新建作品 | airag:video:project:add | |
| 编辑作品和分镜 | airag:video:project:edit | |
| 删除作品 | airag:video:project:delete | |
| AI拆分剧本 | airag:video:project:split | |
| 打包下载 | airag:video:project:download | |
| 合成成片 | airag:video:project:compose | |
| 生成剧照 | airag:video:genImage | |
| 生成视频(计费) | airag:video:genVideo | |
| AI图片库 | 查看图片 | airag:imageLib:list |
| 上传图片 | airag:imageLib:add | |
| 编辑图片 | airag:imageLib:edit | |
| 删除图片 | airag:imageLib:delete |
「生成视频(计费)」会产生费用,可以只授权给需要出片的角色。没有这个权限的用户可以写剧本、拆分镜、出剧照,但不能提交视频生成。
每个用户只能看到自己的作品和图片。
7. 常见问题
Q:生成视频大概要花多少钱?
A:预估费用 = 镜头总秒数 × 分辨率单价。例如本文的动漫短片用火山方舟 Seedance 2.5、480p,15 秒约 10.2 元;同样的镜头用 720p 约 22.65 元。页面上的费用是参考价,以供应商账单为准。建议先用低分辨率、少量镜头试效果。
Q:前后镜头里的人物长得不一样?
A:把角色的「固定外貌」写具体(发型发色、服装配色、配饰等),并在每个镜头里选好出场角色;先出剧照,挑满意的再生成视频;画风保持全片统一。
Q:1080p 的视频在浏览器里放不了?
A:火山方舟 Seedance 的 1080p 是 10bit H.265 编码,部分浏览器不支持播放,打包下载后用播放器观看即可。
Q:镜头生成视频失败了怎么办?
A:卡片下方会显示失败原因:
- 视频已经生成,但保存到系统时失败:点击「重新获取」,不会重复扣费
- 提示「提交结果未知」:提交时服务重启或接口超时,请先到供应商平台确认是否已经生成,再决定是否重新生成,避免重复扣费
- 其他原因(如提示词不合规、余额不足):按提示修改后重新生成
Q:一直显示「AI拆分中」?
A:拆分通常需要 30 秒到 2 分钟。如果中途服务重启,超过 10 分钟会自动结束并提示重新拆分。
Q:「合成成片」按钮是灰的?
A:两种情况,鼠标移到按钮上会提示是哪一种:
- 还有镜头没有生成好视频:所有镜头都是「视频已生成」后才能合成
- 服务器没有安装 ffmpeg:在服务器上安装 ffmpeg,并在配置文件中指定路径
jeecg.ai-chat.ai-model-video.ffmpeg-path(ffmpeg 已在系统 PATH 里时可以不填),然后重启服务
Q:智谱视频模型提示时长不对?
A:智谱只支持 5 秒或 10 秒,把镜头时长改成 5 或 10 后再生成。
Q:生成的剧照和视频保存在哪里?
A:保存到系统的文件存储(按 jeecg.uploadType 配置,本地、MinIO 或阿里云 OSS)的 aivideo/作品ID 目录下,不依赖供应商的临时链接。